REDIAL (2026):从 Embedding 扰动看 RNA 语言模型学到了什么
 fupcode
REDIAL 核心方法:突变一个碱基,观察其他位置的 embedding 怎么变
这篇文章主要回答两个问题:
- 不训练下游预测器,能不能直接读出 RNA 语言模型中的结构信息?
- 一个 12 层的 RNA 语言模型,每一层都有必要吗?
本文基于作者于 2026 年 5 月 12 日发布的 bioRxiv 预印本版本。
评价基础模型依赖下游结构预测
评价基础模型如 RNA-FM时,主要关注的是 RNA-FM 提取 embedding 后,如何通过下游模块生成三维结构。
| |
下游模型可以从结构训练数据中补充信息,也可能记住某些常见结构。因此,最终预测准确,不足以单独证明基础模型学到了可泛化的结构规律。
这篇文章希望绕开下游训练,直接检查预训练模型的表征。
REDIAL:从单点突变到 coupling map
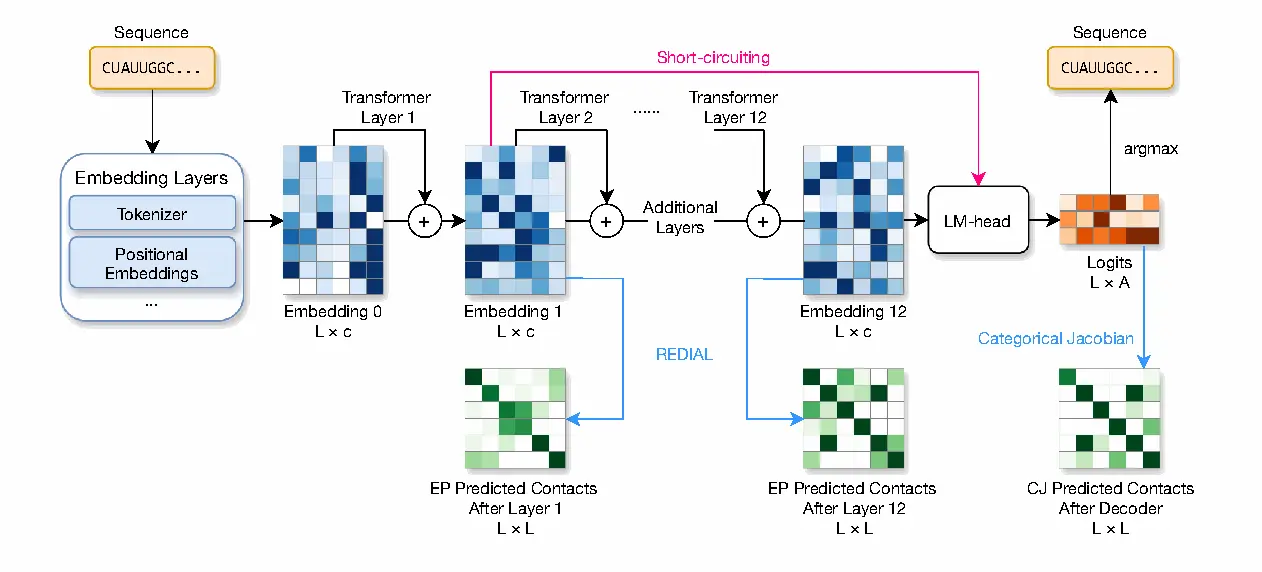
原文 Fig. 1:REDIAL 观察各层 embedding;Categorical Jacobian 观察 LM-head 输出的 logits。
核心思路
如果位置 与位置 存在结构或序列依赖,改变 的碱基,可能影响模型对 的表示。
计算过程
对长度为 的 RNA,模型输出 的 embedding,其中 是 hidden dimension。
- 按通道标准化:让各通道均值为 0、方差为 1,避免少数高幅度通道主导结果。
- 逐位置突变:每个位置枚举 A、C、G、U,包含原始碱基,共 个组合。
- 计算扰动:将突变序列与原序列的标准化 embedding 相减。
- 聚合并去背景:得到位置之间的 coupling map。
用 表示标准化后的 embedding,扰动张量为:
其中, 是突变位置, 是替换碱基, 是被观察的位置, 是 embedding 通道。
按原文 Methods 的公式,对碱基和通道维度取 Frobenius 范数的平方:
随后对称化,并做 Average Product Correction(APC):
APC 用于扣除整体背景效应。最终的 是一个 的耦合分数矩阵,分数高表示模型对这两个位置的关联更敏感。。
结构引导预训练确实改善了可读出的信号
数据与评价指标
- 从 NAKB 筛选单链、无蛋白质或小分子等其他组分的 RNA 结构,并进行清理。
- 主比较使用 533 个结构–序列对,长度 。
- 参考接触由 Barnaba 的碱基相互作用注释构建,排除无法归类的 XXX 相互作用。
- 评分取矩阵上三角,并排除自身及序列相邻位置。
接触对通常比非接触对少,而且比例随序列长度变化,因此作者使用经过基线校正的 PR-AUC:
其中 是参与评价的位置对中真实接触的比例。
随机基线约为 0,完美预测为 1,也可能出现负值。 这里不能把普通 PR-AUC 的随机基线也理解为 0。
结果
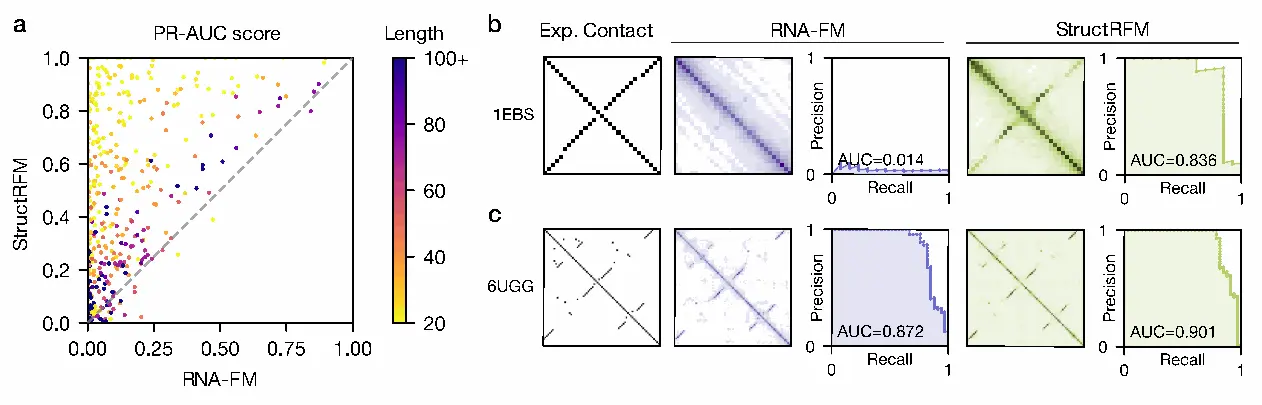
原文 Fig. 4:散点横轴为 RNA-FM,纵轴为 StructRFM;多数点在对角线上方。右侧展示 hairpin 与 tRNA 的具体例子。
- 部分短 RNA:RNA-FM 几乎没有读出有效接触,StructRFM 能恢复茎区及 bulge 导致的配对偏移。
- 部分 tRNA:两个模型都能读出接触,但 StructRFM 的背景更干净。
- 长 RNA 仍然困难:结构引导没有解决所有问题,补充图 S5 中长度大于 100 的序列仍是两个模型的难点。
12 层 Transformer 都在学结构吗?
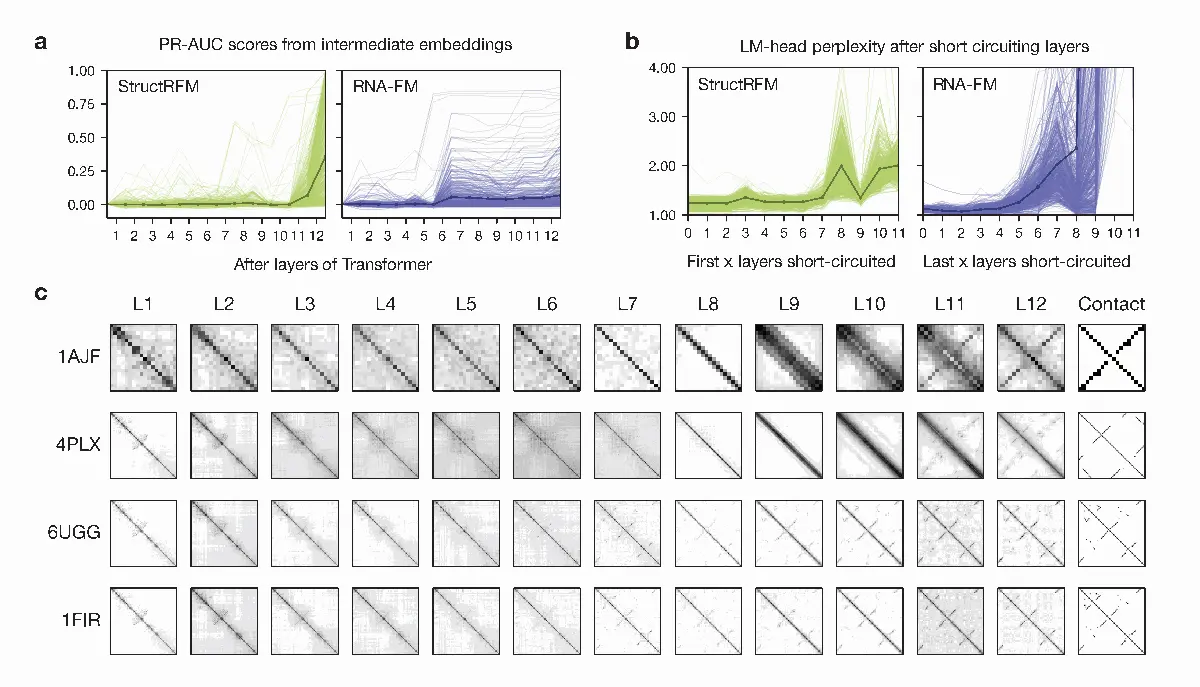
原文 Fig. 5:(a) 比较逐层接触分数; (b) 跳层后的序列恢复表现;(c) 展示 StructRFM 各层读出的 coupling map。
作者做了两类实验:
- 读取中间层:对每层 embedding 分别运行 REDIAL,看结构信号在哪里出现。
- 跳过部分层:将保留下来的表示送入后续模块和原 LM-head,检查 perplexity 等指标。
这两个实验回答的问题不同:前者看结构耦合能否被读出,后者看被跳过的计算是否影响输出。
| 模型 | 逐层观察 | 作者的解释 |
|---|---|---|
| StructRFM | 总体上前 10 层接触信号较弱,最后两层明显增强;部分 tRNA 更早出现信号 | 结构信息集中在后部 |
| RNA-FM | 前约 6 层获得主要接触信号,之后提升有限 | 后续层对结构耦合的贡献较少 |
更直接的证据:删除 StructRFM 前 6 层
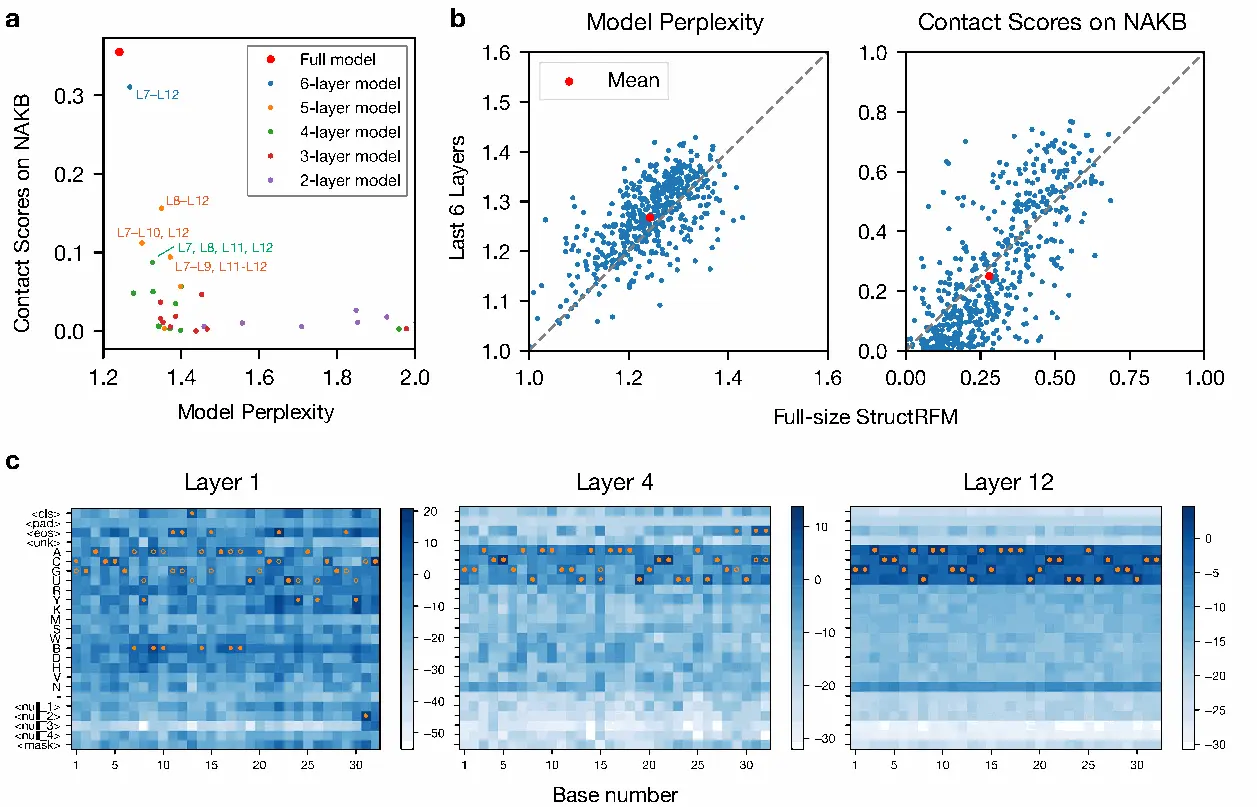
原文 Fig. 6:(a) StructRFM保留 L7–L12 的模型与完整模型比较; (b) RNA-FM 在不同深度输出的 logits。
StructRFM 仅保留 L7–L12 时,接触预测和序列恢复表现整体仍较接近完整模型,但并非完全无损。进一步缩到 5 层,接触预测能力明显下降。
RNA-FM 则呈现另一种现象:前几层已基本确定碱基身份,后面更多是在压低罕见或辅助 token 的概率,使输出分布更尖锐。作者据此提出,词表设计可能影响参数利用效率;这仍需要重新训练不同词表的模型来做因果验证。
我的理解
这些结果表现出了模型对于 REDIAL 这个任务的冗余,但要区分:
- REDIAL 读不出来,不代表该层完全没有有用信息。
- 删层后接触分数接近,不代表所有下游任务都不受影响。
- 参数冗余与过拟合不是同一个概念,后者还需要训练分布与独立测试分布之间的泛化证据。
思考启发
- 提供了一种不借助下游任务,直接比较基础模型的方法
- 减小模型参数量的思路:直接看各层的 coupling map 的变化
参考文献
- Teng, D., Qiu, Y., Sakthivel, G., Aranganathan, A., Herron, L. & Tiwary, P. Detecting and quantifying overparametrization in RNA language models with REDIAL. bioRxiv,2026-05-12 版本。DOI: 10.64898/2026.05.11.724344。